
Jev: ултрабърз и евтин модел, който взема решения, без да генерира текст
Jev е първият System One модел: вместо текст връща решения с вероятности, за около 0,3 секунди. Какво може, какво не и как се справя на български.
Автоматизацията на всеки процес е свързана с вземането на множество малки решения:
- Спам ли е това писмо? -> да (0.97) -> премести го в папка “Спам”
- Към кой отдел да го пренасочим? -> техническа поддръжка (0.80), продажби (0.20)
- Колко сериозен е проблемът? -> 0.7 по скала от 0 до 1
Класически задачи за класификация/категоризация, за чието решаване досега използвахме два подхода:
- Класически ML класификатор. Но тук проблемът е, че трябват етикетирани данни и отделно обучение за всяка задача.
- Чрез LLM, който молим да генерира отговор в JSON (за да може резултатът да се обработи автоматично). Но това е бавно и скъпо, допълнено с излишни обяснения, а понякога JSON-ът е невалиден или отговора е халюцинация.
След 15 септември 2026 г. AI общността полудя по варианта предложен от TypeSafe AI - техния System One модел: Jev. Определено, най-големия хайп, след ChatGPT и OpenClaw. Според мен, след седмица тестване на модела - напълно заслужено.
Jev не генерира текст. Той взема решения и връща типизирани отговори с вероятности. Умопомрачително бързо и изключително евтино.
Името на модела подсказва амбицията на създателите му. Уилям Стенли Джевънс е икономистът, на когото е кръстен парадоксът на Джевънс: когато един ресурс поевтинее многократно, общото му потребление не намалява, а расте. Залогът на TypeSafe е, че когато решенията станат толкова евтини, ще ги вграждаме навсякъде - във всеки if, който досега не си е струвало да бъде “интелигентен”.
System One и System Two модели
Сигурна съм, че тепърва все по-често ще се сблъскваме и с тези концепции, така че нека ги разгледаме.
Към System One се причисляват когнитивните процеси, които работят бързо, интуитивно и без усилия. Например, когато опитен водач шофира по познат път. А когато разсъждаваме осъзнато, последователно, влагайки усилия то задействаме Система 2.
Понятията стават популярни от книгата на Даниел Канеман: “Мисленето - бързо и бавно”
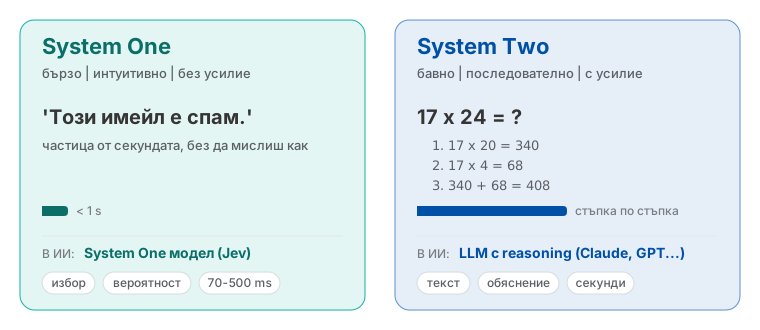
Познатите ни LLMs (Claude, GPT, Gemini …) са аналог на System Two. Разсъждават, пишат, обясняват. Голяма част от решенията в един софтуер, обаче, са от тип System One. За тях не ни трябва есе, трябва ни бърз и надежден отговор, като “този документ е фактура, с вероятност 0,94”.
LLM срещу System One модел (Jev)
| LLM (Claude, GPT…) | System One модел (Jev) | |
|---|---|---|
| Изход | свободен текст | вероятност 0-1, опция от списък, или позиция по скала |
| Как | токен по токен, всеки зависи от предишния | всички отговори наведнъж,паралелно изчисление |
| Формат | трябва да се парсва и валидира; може да е невалиден | гарантиран: не може да върне нещо извън схемата |
| Несигурност | обикновено не я казва, а попитан, е свръхуверен | вероятност за всяка опция + confidence |
| Скорост | 3-329 s | 70-500 ms |
| Входни токени | $0.20-$10 за милион | $0.042 за милион |
| Изходни токени | около 5 пъти по-скъпи от входните | безплатни |
Цифрите са от блога на TypeSafe.
LLM-ът генерира отговора токен по токен, като за всеки следващ се извършва отделно изчисление през цялата мрежа. System One моделът не генерира нищо. Той получава предварително зададени опции и ги оценява всички наведнъж.
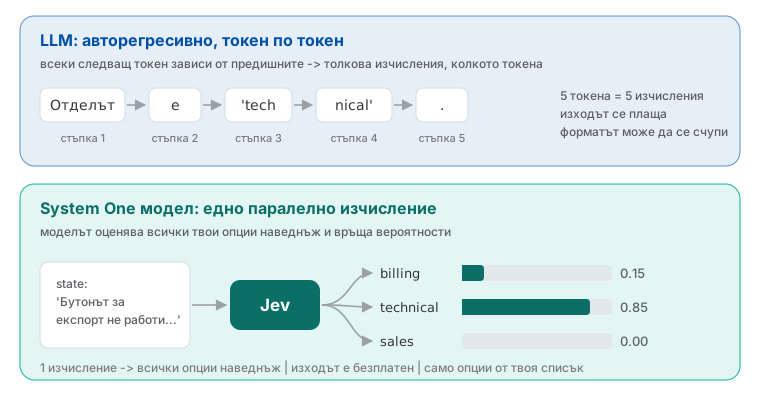
Оттук произтичат три важни характеристики на Jev:
- Изходът е безплатен, защото няма генериран текст.
- Отговорът е бърз, защото мрежата се изчислява само веднъж.
- Форматът е гарантиран: моделът не може да върне опция, която не e в подадените му от нас.
Самите TypeSafe заявяват: Jev не е по-евтин LLM, а типизирана функция, която се оказва интелигентна.
Анатомия на една заявка
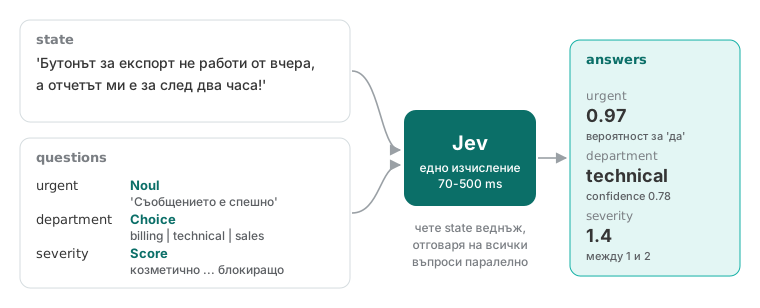
Всяка заявка към Jev има две части:
- State - съдържанието, за което питаме: низ, JSON обект или масив.
- Questions - въпросите, които задаваме за него. Имената им избираме ние. Моделът не ги вижда, те служат само за да намерим отговорите в резултата.
Трите примитива: Noul, Choice, Score
Jev поддържа три вида въпроси, които TypeSafe наричат примитиви.
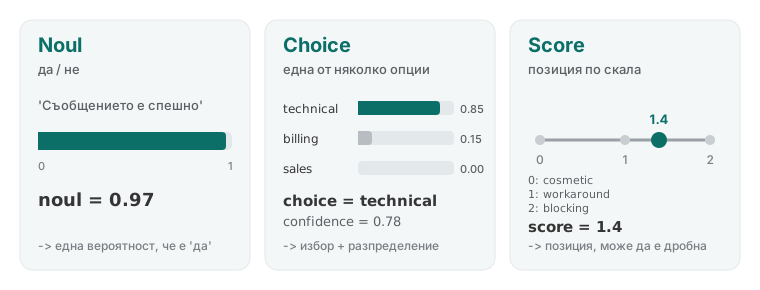
- Noul - да или не. Подаваме твърдение и получаваме вероятност от 0 до 1, че то е вярно. Името е измислено от TypeSafe и няма нищо общо с
null, по-скоро е заигравка с Neural и Bool. - Choice - избор на една от няколко неподредени опции (отдел, тип документ, език). Можете да подадете от 2 до 255 опции за избор (например списък от 50 отдела, 200 категории, 255 държави). Връща избраната опция, вероятността за всяка опция и
confidence. - Score - позиция по подредена скала с 2 до 10 нива. Връща
score- средното, претеглено с вероятностите, затова може да е дробно число. Например 1,48 означава колебание между ниво 1 и ниво 2.
Пример
Ето един прост, но реален пример с официалното Python SDK (typesafe-sdk) - три въпроса наведнъж за едно съобщение до техническата поддръжка:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()          # чете API ключа от средата

response = client.system_one(
    state="Здравейте, от вчера бутонът за експорт не работи, "
          "а отчетът ми трябва след два часа!",
    questions={
        "urgent": Noul(instructions="The message conveys urgency or time-sensitivity"),
        "department": Choice(
            instructions="Which team should handle this message",
            criteria={
                "billing":   "Payment, invoice or subscription issues",
                "technical": "Bugs, errors or integration problems",
                "sales":     "Pricing questions or buying more seats",
                "other":     "Anything that fits none of the above",
            },
        ),
        "severity": Score(
            instructions="How severe is the reported problem",
            criteria=[
                "No problem or cosmetic issue",
                "Problem with a workaround",
                "Blocking problem, no workaround",
            ],
        ),
    },
)

print(response.nouls["urgent"].noul)               # 0.99 => urgent
answer = response.choices["department"]
print(answer.choice, answer.confidence)            # technical 1.0
print(response.scores["severity"].score)           # 1.99 (скала 0-2) => Blocking problem, no workaround
Добрата практика е всички въпроси да са в една заявка. Моделът чете state веднъж и отговаря на въпросите паралелно и независимо един от друг. Всеки допълнителен въпрос почти не увеличава цената.
Пуснах същите три въпроса върху други пет съобщения на български.
| State | Urgent | Department (confidence) | Severity 0-2 (confidence) |
|---|---|---|---|
| “…бутонът за експорт не работи, а отчетът ми трябва след два часа!” | 0,99 | technical (1,00) | 1,99 (0,98) |
| “Таксувахте ме два пъти за поръчка A-104. Искам си парите обратно.” | 0,33 | billing (1,00) | 1,48 (0,23) |
| “Колко струва да добавим още петима потребители към плана?” | 0,06 | sales (0,97) | 0,03 (0,96) |
| “Логото на входната страница е изместено с два пиксела.” | 0,05 | technical (0,99) | 0,01 (0,98) |
| “хм, не съм сигурен, може би онова от миналия път?” | 0,04 | other (0,96) | 0,12 (0,82) |
И в петте случая отделът е определен правилно. Последното, неясно съобщение попадна в other - точно за такива случаи е тази опция.
Най-интересен е вторият ред. Двойното таксуване не е бъг, а скалата за сериозност на проблема (severity) описва бъгове. Моделът дава 1,48, но с увереност едва 0,23, тоест “не знам”. Това е информация, която от LLM обикновено не получаваме.
Скорост: 300-500 ms на заявка, мерено от София през Vercel AI Gateway. Цена: около 460 входни токена на заявка, тоест около $0.00002. Милион такива съобщения струват около $20.
Вероятност (probabilities) срещу увереност (confidence)
Choice и Score връщат две стойности, които лесно се бъркат:
probabilities- разпределението на вероятността по опциите, със сбор 1;confidence- едно число от 0 до 1, изчислено от формата на това разпределение. Ако цялата вероятност е в една опция, увереността е 1. Ако е разпределена равномерно - 0.
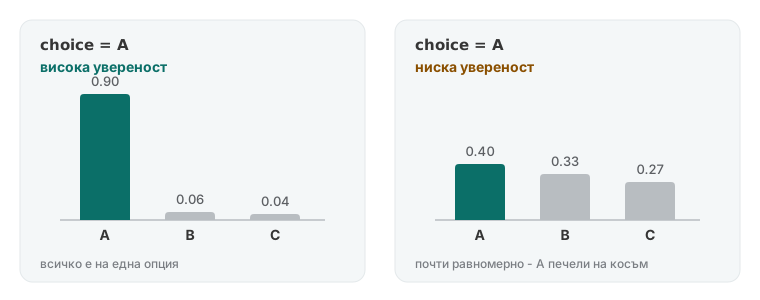
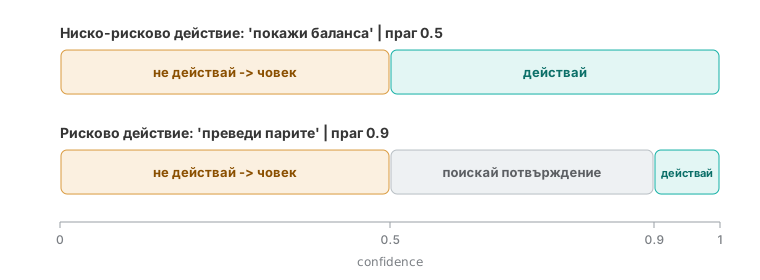
Именно confidence позволява на кода да каже “не знам, питай човек”. На практика е удобно да има три зони: при висока увереност системата действа сама, при средна иска потвърждение, при ниска прехвърля случая на човек. Прагът расте с риска: грешно показан екран се поправя лесно, грешен превод на пари - не.
Jev е обучен вероятностите му да са калибрирани: когато казва 0,8, да е прав в около 80% от тези случаи. Калибрирането обаче трябва да се провери, а не да се приема на доверие. Но това ще разгледам в отделен пост.
Какво значи “0% халюцинации”
TypeSafe рекламират Jev с “0% халюцинации”. В тесния смисъл това е вярно: моделът не може да върне отговор извън зададените. Ако не сме изброили отдел marketing, няма как да го получим.
Това не значи, че моделът винаги е прав. Той може да избере грешна опция от списъка. Затова връща confidence и затова точността трябва да се измери върху собствени данни.
Къде е силен и къде не
Jev е подходящ навсякъде, където решението е избор между предварително известни опции:
| Област | Пример | Примитив |
|---|---|---|
| Маршрутизиране | към кой отдел, агент или модел отива заявката | Choice |
| Триаж | колко спешно е, колко сериозен е проблемът | Score |
| Модерация | спам, обиди, забранено съдържание | Noul |
| Класификация на документи | фактура, договор или CV -> папка | Choice |
| Филтър за RAG | кои от 50 намерени пасажа отговарят на въпроса | Noul за всеки пасаж |
| Предпазител за LLM | съдържа ли отговорът лични данни | Noul |
RAG (retrieval-augmented generation) е подход, при който LLM отговаря въз основа на предварително зададено документи.
Jev не е подходящ за:
- генериране на текст, код, резюмета или отговори на писма - просто не може;
- смятане, броене и сравняване на дати - това е работа за кода;
- решения, при които трябва да се обясни защо (одит, право);
- сложни еднократни разсъждения - там LLM е по-добрият избор.
Каскада: Jev, LLM и човек заедно
Най-добрата архитектура обикновено не е “или-или”, а комбинация.
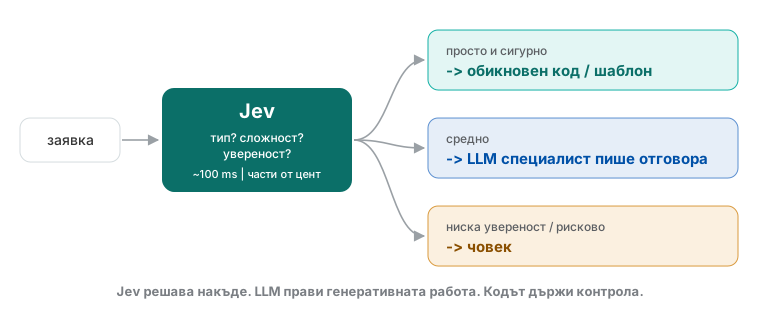
Jev бързо и евтино решава накъде да отиде всяка заявка. LLM-ът върши генеративната работа само там, където тя е нужна. Човекът получава несигурните и рисковите случаи. А кодът държи контрола.
Същата идея важи и за сложните решения. Вместо да питаме модела “да върнем ли парите?”, разбиваме въпроса на атомарни части (“иска ли клиентът възстановяване?”, “покрива ли го политиката?”) и ги комбинираме с обикновени if-ове. Така логиката остава видима, тестваема и под наш контрол.
Има ли отворена алтернатива?
Jev е затворен модел: теглата не са публикувани, достъпът е само през API. Идеята и форматът на API-то обаче са отворени и само за седмица се появиха десетки отворени проекти - каталогът madewithjev.com изброява 35. Засега те са по-бързи и безплатни, но видимо по-неточни. В единственото независимо сравнение върху едни и същи задачи изостават с 25-40 процентни пункта.
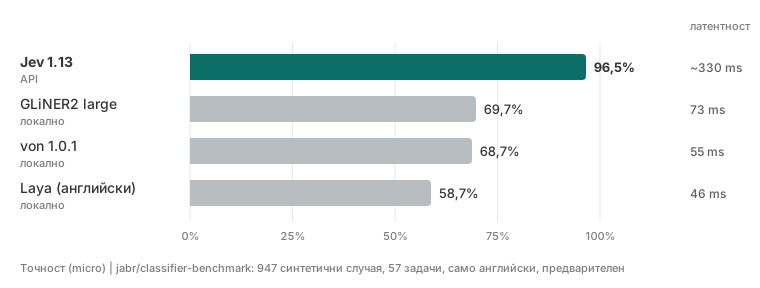
Локалните модели от сравнението:
| Модел | Страница |
|---|---|
| GLiNER2 large | huggingface.co/fastino/gliner2-large-v1 |
| von | github.com/wfzyx/von |
| Laya (английски) | huggingface.co/convaiinnovations/laya |
| Laya multilingual | huggingface.co/convaiinnovations/laya-multilingual |
Ако ни трябва български и нямаме видеокарта, изборът е: Laya multilingual - 322 милиона параметъра, лиценз Apache 2.0, работи на процесор. С нея направих малък блог с автоматични категории, изцяло на български. Пишеш пост и моделът предлага категория: една от съществуващите или нова, ако постът не пасва никъде. Приемаш или поправяш с едно щракване. Когато темата е нова, малък локален LLM (BgGPT) измисля име и описание на категорията, а оттам нататък System One моделът я предлага като всички останали. Работи на процесора, безплатно е, а кодът е отворен: GitHub.
Как да вземем ранен достъп
Естествено, след всичко това ви се иска да го пробвате. Има два пътя.
Първият е директно при създателите: през конзолата на TypeSafe се записвате за ранен достъп и получавате API ключ. Лошата новина е, че за момента приемането на нови потребители е паузирано - самите те го обявиха в X. Затова аз не чаках.
Вторият път е през Vercel AI Gateway, където Jev е достъпен като typesafe-ai/jev. Правите си ключ във Vercel, сменяте адреса на API-то и същият код работи без промяна. Именно така направих всичките си тестове.
Заключение
System One моделите не са по-евтина версия на LLM, а различен инструмент. Те запълват място, което досега беше празно: решения, за които класическият класификатор изисква твърде много подготовка, а LLM е твърде бавен и скъп за всяко извикване.
Все пак не бих се доверила нито на рекламата, нито на моите пет съобщения. Най-сигурният начин е да съберем 30-50 примера с верен отговор от собствените си данни и да измерим.
Източници
- Introducing System One Models & Jev - TypeSafe AI Blog
- Документация на TypeSafe: Primitives, State, Confidence, Models
- Python SDK
typesafe-sdk0.7.1 - PyPI, GitHub - Simon Willison - Jev introduces a new shape of LLM
- Flavio Copes - A deep dive into Jev
- jabr/classifier-benchmark - Jev, von, GLiNER2 и Laya върху едни и същи 947 случая
- madewithjev.com - open alternatives
- Laya multilingual